import torchfrom datasets import Audio, load_datasetfrom transformers import AutoModelForCTC, AutoProcessor, AutoModelForTokenClassification
parakeet_processor = AutoProcessor.from_pretrained("nvidia/parakeet-ctc-1.1b")parakeet_model = AutoModelForCTC.from_pretrained(    "nvidia/parakeet-ctc-1.1b", dtype="auto", device_map="cuda",)
aligner_model_id = "Qwen/Qwen3-ForcedAligner-0.6B-hf"aligner_processor = AutoProcessor.from_pretrained(aligner_model_id)aligner_model = AutoModelForTokenClassification.from_pretrained(    aligner_model_id, dtype=torch.bfloat16, device_map="cuda",)
ds = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")ds = ds.cast_column("audio", Audio(sampling_rate=parakeet_processor.feature_extractor.sampling_rate))audio_arrays = [ds[i]["audio"]["array"] for i in range(3)]sr = ds[0]["audio"]["sampling_rate"]
# Batch transcribe with Parakeetinputs = parakeet_processor(audio_arrays, sampling_rate=sr, return_tensors="pt", padding=True).to(    parakeet_model.device, dtype=parakeet_model.dtype)with torch.inference_mode():    outputs = parakeet_model.generate(**inputs)transcripts = parakeet_processor.decode(outputs)
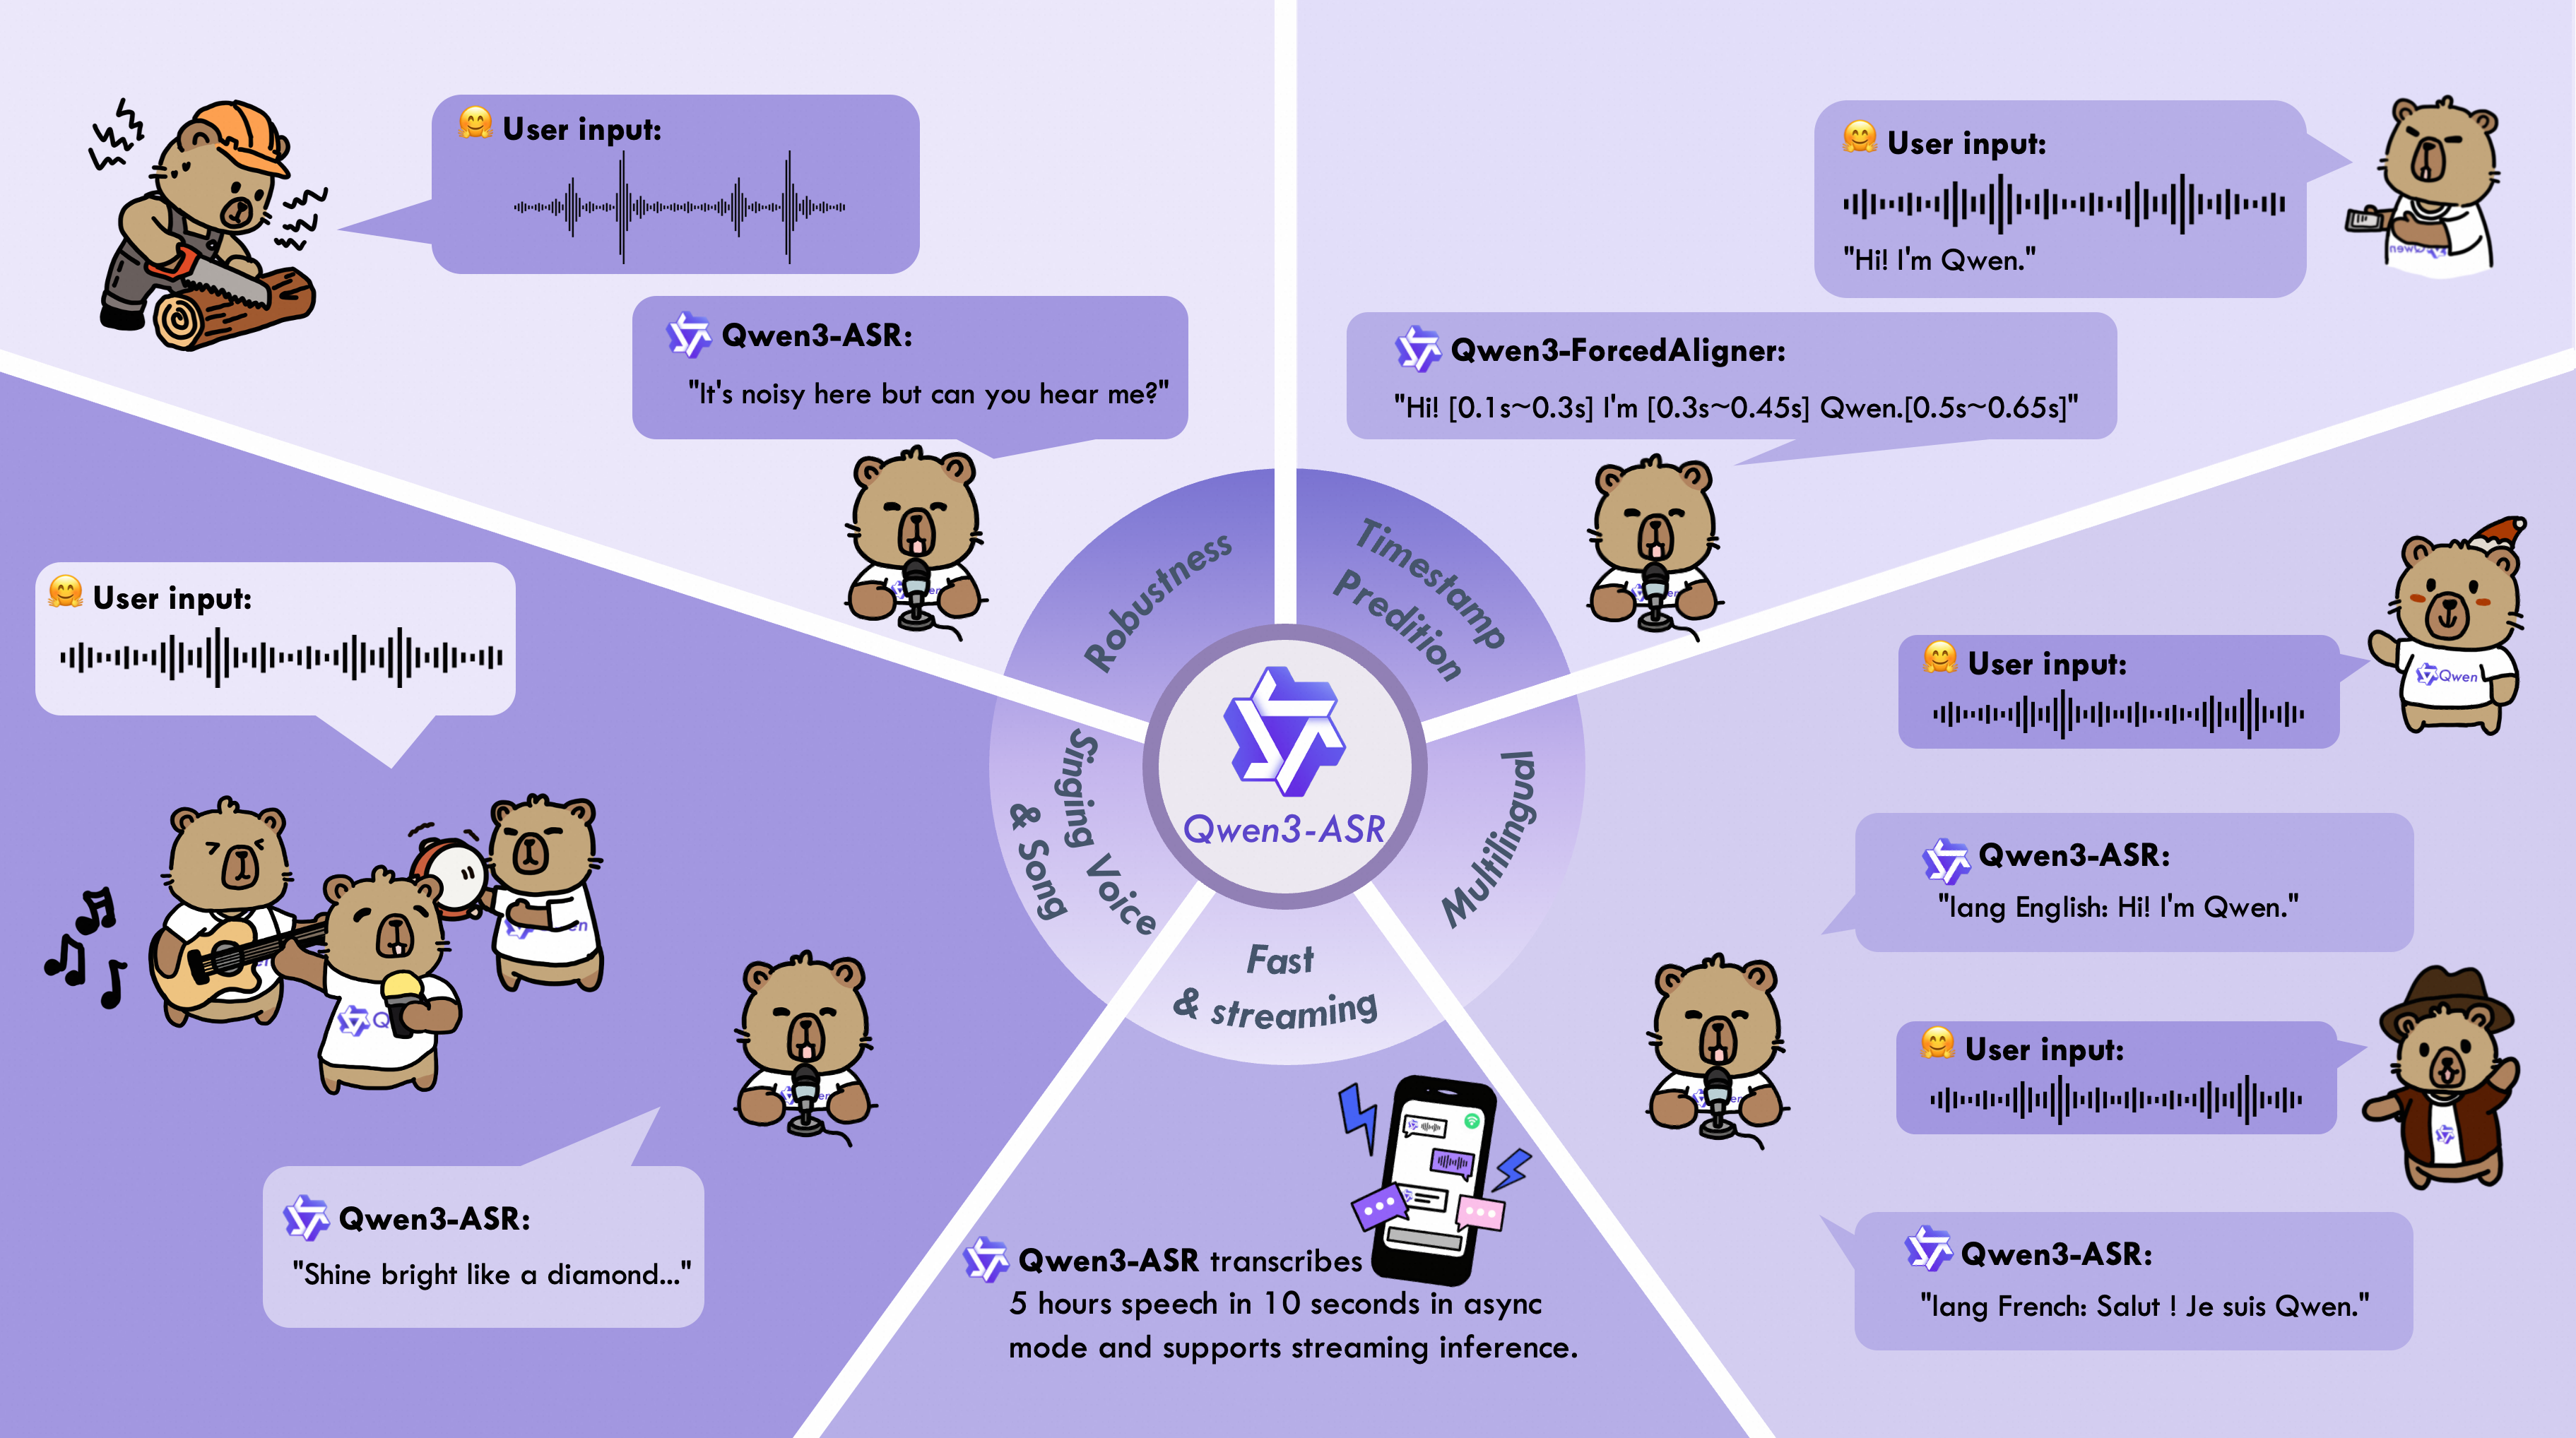
# Batch align with Qwen3 Forced Aligneraligner_inputs, word_lists = aligner_processor.prepare_forced_aligner_inputs(    audio=audio_arrays, transcript=transcripts, language="English",)aligner_inputs = aligner_inputs.to(aligner_model.device, aligner_model.dtype)
with torch.inference_mode():    aligner_outputs = aligner_model(**aligner_inputs)
batch_timestamps = aligner_processor.decode_forced_alignment(    logits=aligner_outputs.logits,    input_ids=aligner_inputs["input_ids"],    word_lists=word_lists,    timestamp_token_id=aligner_model.config.timestamp_token_id,)
for i, (transcript, timestamps) in enumerate(zip(transcripts, batch_timestamps)):    print(f"\n[Sample {i}] {transcript}")    for item in timestamps[:5]:        print(f"  {item['text']:<20} {item['start_time']:>8.3f}s → {item['end_time']:>8.3f}s")    if len(timestamps) > 5:        print(f"  ... ({len(timestamps) - 5} more words)")